第 2 週:資訊素養與判斷力
上一週,我們認識了數位世界的全貌。這一週,我們要處理一個更貼身的問題:在這個資訊量遠超我們處理能力的環境裡,我們要如何判斷一則訊息是真是假?這不只是生活技能,更是會計專業的核心——因為會計的本質,是為資本市場提供可信的資訊。在過去的案例中,有假訊息偽裝成財報、偽裝成主管的視訊、偽裝成政府公文時,「查證」這項能力,就成了專業人員最重要的防線。本週我們將學習一套全世界事實查核人員都在用的方法,並在課堂上實際練習。
📋 本週學習目標
- 理解「資訊社會」的定義包含「環境」與「能力」兩個條件,並認識台灣在環境面的發展現況
- 說明資訊超載的形成原因,以及它與認知判斷之間的關係
- 辨識三種常見的認知偏誤(確認偏誤、可得性捷思、光環效應),並說明其在專業判斷中的影響
- 區分錯誤資訊、虛假資訊與惡意資訊三種型態,並理解其對應的處理方式
- 認識大型語言模型的生成本質與「AI 幻覺」,說明為何 AI 產出需要人工查證
- 熟練運用 SIFT 數位查證四步法(Stop、Investigate、Find better coverage、Trace)與橫向閱讀法
- 應用 SIFT 四步法於四組擬真案例,指出判斷依據並說明理由
- 連結查證方法與會計專業的「職業懷疑心(Professional Skepticism)」,理解其與審計實務的關聯
⏱ 預估閱讀時間:約 60-90 分鐘 | 關鍵詞:資訊社會、資訊超載、注意力經濟、同溫層、認知偏誤、確認偏誤、可得性捷思、資訊失真三光譜、大型語言模型、AI 幻覺、深度偽造、SIFT、橫向閱讀、職業懷疑心、事實查核
2.1 從資訊社會到資訊超載
我們先從一個定義開始。教科書第 2 章對「資訊社會」的定義是:指一個社會中所有成員是否具備資訊處理和運用的能力,且該社會是否擁有足以讓這些能力充分發揮的資通訊科技環境[1]。
這個定義看起來簡單,但請注意它包含兩個條件:
第一個是「環境」——資通訊科技的基礎設施是否普及;
第二個是「能力」——社會成員是否具備資訊處理與運用的能力。這兩個條件必須同時成立,才稱得上是成熟的資訊社會。
環境面的進展:台灣的位置
先看第一個條件。在環境面,台灣(以及全球多數地區)在過去二十年有相當明顯的進展。
根據 DataReportal 在 2025 年 10 月公布的《Digital 2026 Global Overview Report》,全球上網普及率平均為 73.2%,相當於全球約 82.5 億人口中,有約 60.4 億人能夠使用網際網路[2]。區域之間的落差雖然仍存在,但整體覆蓋率已大幅提升:
| 區域 | 上網普及率 | 區域 | 上網普及率 |
|---|---|---|---|
| 北歐 | 97.7% | 非洲南部 | 77.6% |
| 西歐 | 95.1% | 大洋洲 | 77.5% |
| 北美 | 93.3% | 北非 | 73.5% |
| 東歐 | 92.7% | 全球平均 | 73.2% |
| 南歐 | 91.6% | 南亞 | 64.3% |
| 東亞 | 90.1% | 西非 | 42.9% |
| 南美 | 83.8% | 中非 | 33.5% |
| 東南亞 | 82.9% | 東非 | 26.0% |
資料來源:DataReportal《Digital 2026 Global Overview Report》[2]
在國家競爭力方面,瑞士洛桑管理學院(IMD)公布的《世界數位競爭力排行榜》2025 年結果,將 69 個經濟體列入評比(俄羅斯、烏克蘭未列入評比名單),第一名為瑞士,其後依序是美國、新加坡、香港、丹麥;臺灣排名第 10,中國大陸第 12,日本第 30[3]。另一項指標《網路整備度指標 2025》(Network Readiness Index 2025)的前五名則為美國、芬蘭、新加坡、丹麥、瑞典[3]。
這些數據說明了第一件事:在「環境」這個條件上,台灣的表現相當良好。
本週的核心提問:既然環境條件已經到位,那麼定義中的第二個條件——「資訊處理與運用的能力」——我們準備好了嗎?這個問題,正是「資訊素養與判斷力」這門課要處理的課題。
資訊超載 — 當資訊量超越處理能力
在討論「能力」之前,我們需要先理解這個環境帶來的一項新現象。教科書第 2 章將「資訊超載與電腦錯誤」列為電腦帶來的首要負面影響[1]。這是一個客觀的技術現象,可以從幾個角度理解。
第一,產出速度的量級變化。過去資訊的產出需要經過編輯、印刷、配送等流程,速度受限於實體媒介的物理條件。現在任何人、任何地點、任何時間都可以發布資訊,且發布成本趨近於零。這造成了資訊總量與個人處理能力之間的落差持續擴大。
第二,注意力是有限資源。心理學研究指出,人類的注意力資源是有限的。當同時面對大量資訊時,人無法對每一則資訊都進行完整分析。這是認知系統的設計特性,與個人的努力程度無關。
第三,捷思的運作。當資訊量遠超處理能力時,大腦會傾向採用捷思(heuristics,經驗法則)進行快速判斷。捷思在大多數日常情境中相當有效——它讓我們不必對每件事都從頭分析。但捷思也有一個特性:它依賴的是「容易想到」而非「經過驗證」。這個特性會在 2.2 節進一步說明。
理解資訊超載是一項客觀的環境變化後,我們便能思考對應的方法——而不是把問題歸因於個人的意志力。用方法因應環境,而非用責備因應環境,這是本週課程要建立的視角。
資訊的流通機制 — 推薦系統的排序依據
理解了資訊超載之後,下一個問題是:在這麼多資訊中,我們實際上「看到」的是哪一些?這就涉及內容推薦系統的運作方式。
社群平台與內容網站的營運,主要依賴廣告收入。廣告的計價基礎,與使用者的停留時間(time on site)及互動頻率(engagement)高度相關。也就是說,平台的核心營運指標,就是使用者願意在平台上停留多久、互動多少次。
這個結構本身是中性的——它是一種商業模式。但它帶來一個值得注意的結果:內容推薦系統的功能,是從海量內容中挑選出使用者可能感興趣者;而判斷「感興趣」的依據,來自過往的互動數據。研究與實務都顯示,能引發情緒反應的內容,通常能獲得較高的互動。
因此,推薦系統的最佳化目標,實際上是「互動程度」。這與「內容是否正確」是兩個不同的維度:
| 比較項目 | 是否為推薦系統的排序依據 |
|---|---|
| 使用者可能點擊/停留 | ✅ 是 |
| 使用者可能留言/轉發 | ✅ 是 |
| 內容是否符合事實 | ❌ 不是(系統無從自動判定) |
這裡要強調的是:這不是誰的過錯,而是系統設計目標與資訊正確性之間的差異。理解這一點,就能理解為什麼我們需要一套額外的查證方法——因為推薦系統本身不負責這件事。
使用行為的設計面
教科書第 2 章也將「電腦沉迷與網路成癮」列為電腦帶來的負面影響之一[1]。從產品設計的角度來看,現代數位產品確實運用了若干機制來提升使用者的使用頻率與時長:
- 無限捲動(infinite scroll):移除「到底了」的自然停止點,使內容消費沒有明確終點。
- 推播通知(push notification):主動將使用者帶回應用程式。
- 不定時回饋(variable reward):回饋時機不固定,容易形成持續查看的習慣。
理解這些機制,有助於使用者有意識地使用這些工具——知道產品是如何被設計的,就能自行決定使用的節奏與界線。這與教科書提到的「操作環境」與「人體工學」其實指向同一件事:使用習慣是可以透過理解而調整的。
同溫層與回音室 — 個人化推薦的連帶效應
個人化推薦的運作方式是:根據使用者過往的點擊、停留、互動紀錄,推測其偏好,再推薦相似內容。長期下來,使用者接收到的資訊會逐漸集中於既有偏好的範圍內。這個現象被稱為同溫層(Filter Bubble,資訊濾泡)。它是一項連帶效應,不是刻意設計的結果,其特徵包括:
- 使用者不容易察覺自己接收的資訊已被篩選
- 因為推薦內容「符合自己的興趣」,使用體驗通常是正面的
- 但資訊的多樣性會逐漸降低
當一群人聚集在封閉的社群中,彼此的觀點反覆相互確認,會產生另一種認知效果,稱為回音室效應(Echo Chamber):成員會感覺「大家都是這樣想的」。這裡需要區分兩件事:
| 層面 | 實際情形 |
|---|---|
| 群體內的感受 | 「這是普遍共識」 |
| 客觀事實 | 這是該群體的內部共識,未必反映整體社會 |
理解同溫層與回音室,是 SIFT 四步法中「F(Find better coverage,尋找更佳報導)」的理論基礎:如果我們接收的資訊可能已被個人化篩選,那麼「主動尋找不同來源」就不只是額外的動作,而是必要的方法。
資訊失真的三種型態
並非所有不正確的資訊都基於同樣的原因。依動機與性質,學界將其分為三類[4]:
| 類型 | 英文 | 定義 | 散布者的動機 | 常見例子 |
|---|---|---|---|---|
| 錯誤資訊 | Misinformation | 內容不實 | 無惡意 | 善意轉傳未經查證的健康資訊 |
| 虛假資訊 | Disinformation | 蓄意捏造 | 帶有目的 | 為操縱輿論而製作的不實內容 |
| 惡意資訊 | Malinformation | 內容為真,但脫離原情境 | 意圖造成特定影響 | 將真實發言截斷、去脈絡化後散布 |
這個分類的教學價值在於:三者的差別是動機,而動機決定了對應的處理方式。
- 錯誤資訊 → 可透過教育與查證習慣的建立來改善
- 虛假資訊 → 需要來源查證與交叉比對
- 惡意資訊 → 特別需要「追溯原始脈絡」(即 SIFT 的 T 步驟),因為內容本身可能沒有明顯錯誤
精確的分類,能讓我們選擇正確的工具。這是資訊判斷力訓練的專業所在。
資訊的變現方式
理解資訊如何被轉換為收益,有助於判斷「某一則訊息為什麼會被製作出來」。這是一個實用的判斷線索。
第一種是內容農場的流量變現。運作結構是:製造吸引點擊的標題 → 獲得流量 → 以流量換取廣告收益。其特徵是以點擊數量為目標,因此標題的吸引力往往優先於內容的正確性。
第二種是股市不實題材炒作(Pump-and-Dump)。運作結構如下:
| 階段 | 操作 | 訊息的角色 |
|---|---|---|
| 建立部位 | 低價買進冷門標的 | — |
| 拉抬(Pump) | 散布利多題材,吸引買盤 | 訊息在此階段被製造 |
| 出貨(Dump) | 於高點賣出 | — |
| 結果 | 價格回落 | 訊息已完成其功能 |
當一則訊息「對誰有利」變得清楚時,它就提供了一個判斷線索。理解訊息的產生背景,是查證的一部分。
技術基礎設施的雙向性
教科書第 2 章介紹了當代資訊社會的技術基礎[1]:
| 技術 | 英文 | 功能 |
|---|---|---|
| 物聯網 | Internet of Things, IoT | 各式裝置連網並交換資料 |
| 機器對機器 | Machine To Machine, M2M | 裝置間自動化通訊 |
| 雲端儲存/運算 | Cloud Storage / Computing | 資料與算力的集中化服務 |
| 大數據/資料探勘 | Big Data / Data Mining | 大量資料的分析與應用 |
各產業透過異業合作,將智慧應用深入到各行各業。而這些技術有一項重要特性:它們本身是中性的——價值取決於使用方式。同一套技術,可以讓正確的資訊迅速傳遞到需要的人手上,也可以讓不實的資訊迅速擴散。
理解技術的中性,才能把關注點定位在「使用方式」與「判斷能力」上。這也解釋了為什麼本週課程的重點是「培養能力」,而不是「評價技術」。
從「數位落差」到「識讀落差」
教科書第 2 章介紹了「數位落差」的概念[1]。傳統的數位落差(digital divide)關注的是基礎條件的差距——即不同地區或群體之間「能否上網」的差異。教科書引用的數據顯示,這項落差雖然仍存在,但已逐步縮小。
值得注意的是:當上網普及率逐步提升、基礎設施的差距縮小之後,一項新的課題隨之出現:
能夠上網,與能夠正確判讀所接收的資訊,是兩種不同的能力。這可以理解為「數位落差」的下一階段——基礎建設解決了「連線」的問題,而資訊素養處理的是「判讀」的問題。
資訊素養是數位環境成熟後的下一階段功課。這正是本週課程的定位——從「有沒有環境」進展到「有沒有能力」。
資料的生命週期
教科書第 2 章在討論「廢棄電腦與回收處理」時,引述了美國環境保護署(EPA)的估計:在美國售出的電腦中,約有四分之三被囤積而未妥善處理;這些設備最終可能進入掩埋場、焚化爐,或出口至亞洲[1]。教科書並介紹了幾個國際電子廢棄物處理體系的實例。
| 機構 | 計畫/內容 |
|---|---|
| 香港環境保護署 | 「電腦及通訊產品回收計劃」(Computer & Communication Products Recycling Programme) |
| 綠色和平國際 | “Where does e-waste end up?” 專題 |
| 美國環保署(EPA) | Regulations, Initiatives and Research on Electronics Stewardship |
| NCER | National Center for Electronics Recycling:“Why Recycle Electronics?” |
| 德國聯邦環境署 | Electrical and electronic waste 專題 |
從資料治理的角度來看,電子設備的汰換涉及一個容易被忽略的環節:儲存媒體(硬碟、隨身碟、記憶卡)中,可能仍留有財務資料、客戶名單與個人身分資料。因此在會計與稽核實務中,報廢設備的資料銷毀需要有紀錄、有程序——這是內部控制的一部分。
儲存媒體的處置,是資料治理流程的一部分。這與第 1 週的「數位足跡」相互呼應——資料的留存不僅在雲端,也存在於實體設備之中。
案例:一則流傳兩百年的金融傳奇
接下來這個案例,用於示範「追溯(Trace)」這個步驟如何運作,呈現來源查證的方法與價值。
流傳的版本是這樣的:1815 年滑鐵盧戰役期間,內森·羅斯柴爾德(Nathan Rothschild)建立了專屬的通訊網絡,比英國官方更早得知威靈頓公爵獲勝的消息。他在倫敦證券交易所先大量拋售英國公債,引發價格下跌,再於低點大量買進,因而獲得巨額利潤。
這則敘述具備完整的故事要素——資訊優勢、市場操作、可觀報酬,因此長期被引用為「資訊即財富」的例證。
經溯源,這則敘述最早出現在 1846 年於巴黎出版的一本小冊子,作者署名「Satan」(真實身分為 Georges Dairnvaell)。新聞學者 Brian Cathcart 為羅斯柴爾德檔案館(The Rothschild Archive)年刊撰寫的研究,以及他在英國《獨立報》(The Independent)2015 年的調查報導,根據當時的公開紀錄進行查證[5][6],結果如下:
| # | 流傳敘述 | 考證結果 |
|---|---|---|
| 1 | 內森在滑鐵盧現場 | 他當天不在滑鐵盧,也不在比利時 |
| 2 | 建立了信鴿或快船通訊網 | 檔案中查無相關紀錄 |
| 3 | 拋售公債引發價格崩跌 | 當日公債價格並未下跌。與戰局關聯最密切的政府公債 Omnium,當日開盤為 4¾% 溢價,盤中升至 6%,收盤回到 4¾% |
| 4 | 他是倫敦最早得知消息者 | 另有他人自比利時根特快馬返抵倫敦,且消息當日中午前已經見報 |
| 5 | 因此獲取巨額財富 | 他確實因較早獲得消息而有所獲利,但規模與同時期其他更低價買進的投資人相比並不突出 |
為什麼這則敘述會被廣泛接受?因為它曾被收錄於多部重要參考著作之中,包括《大英百科全書》、《國家傳記辭典》,以及若干暢銷歷史傳記。當一個說法反覆出現在具權威性的來源中,讀者容易將其視為已確認的事實。
| 觀察 | 對應的方法 |
|---|---|
| 權威來源也可能沿用未經查證的敘述 | 需回到原始證據(SIFT 的 T 步驟) |
| 價格紀錄可直接檢驗敘述的真偽 | 優先查證「可驗證的原始數據」 |
| 敘述的流傳時間長,不代表其正確性 | 流傳廣度與正確性是兩個維度 |
來源的權威性,不能取代對原始證據的查證。這正是 SIFT 中「T(Trace 追溯)」步驟的價值所在。
2.2 大腦的捷思與認知偏誤
請先思考這道題目,憑直覺回答,不需要計算:
多數人心中第一個浮現的答案是「100 元」。但正確答案是「50 元」——因為球棒是 1,050 元,球是 50 元,加起來正好 1,100 元,且球棒確實比球貴 1,000 元。
這道題的價值在哪裡?即使在知道正確答案之後,多數人仍然需要花費幾秒鐘重新計算,才能確認 50 元是對的。這說明了一件事:我們的大腦並非只有一種運作模式。它有兩套系統,而且預設使用的是比較省力的那一套。
這個架構,由諾貝爾經濟學獎得主 Daniel Kahneman 在《快思慢想》(Thinking, Fast and Slow, 2011)中提出[7],是理解資訊判讀的重要基礎。
雙系統思維(System 1 vs. System 2)
| 比較項目 | 系統一(快思) | 系統二(慢思) |
|---|---|---|
| 運作方式 | 直覺、自動化 | 邏輯、審慎分析 |
| 能量消耗 | 極低 | 較高 |
| 速度 | 快 | 慢 |
| 是否需刻意啟動 | 否(預設模式) | 是 |
| 適用情境 | 日常快速判斷 | 複雜分析、查證 |
| 剛才的答題 | 回答「100 元」 | 計算出「50 元」 |
這裡有兩個關鍵特性。第一,系統一是預設模式。日常生活中的絕大多數判斷,都由系統一處理。這是大腦的效率設計——如果每件事都要動用系統二,能量消耗將難以負荷。
第二,系統二需要刻意啟動。它的能力較強,但不會自動上場。它的啟動需要一個明確的動作,例如察覺到「這件事好像不太對」、意識到「我需要確認一下」,或決定「先不要急著反應」。
核心命題:查證這個動作,本質上就是「刻意啟動系統二」。它不會自動發生,需要一個刻意的觸發動作。這個觸發動作,正是下一節 SIFT 第一步「S(Stop,停下來)」要處理的事。
三種常見的認知偏誤
系統一在處理資訊時,會運用若干效率機制。這些機制在多數情況下有效,但在特定情境下會產生可預期的偏差。以下三種與資訊判讀的關聯最為直接。
不過在介紹之前,先釐清一個常見的討論。很多人以為「假訊息是長輩才會信的,我們是數位原住民,不會被騙」。
實證研究確實發現一個現象:美國學者 Guess、Nagler 與 Tucker 發表於《Science Advances》的研究顯示,65 歲以上的使用者分享假新聞連結的比率,約為 29 歲以下族群的 7 倍——即使在控制了黨派立場、意識形態與教育程度之後,這項差異依然存在[16]。
但這個數字的原因值得說明,而且學界目前仍在討論。該研究提出的解釋是:年長者的數位媒體識讀訓練機會較少,使用數位媒體的習慣也不同[16]。
另一條常被討論的線索是重複曝光效應(同一則訊息看過多次就覺得可信)。不過這條線索的證據並不一致:
| 研究方向 | 發現 |
|---|---|
| 實驗室研究(Brashier & Schacter, 2020) | 在控制條件下,重複曝光使訊息顯得可信的幅度,年輕人與年長者相當[17] |
| 真實平台資料分析(Harvard Misinformation Review) | 重複曝光的影響隨年齡增加,60 歲以上最明顯——但研究者也指出各年齡層的差異「實質上相當小」[18] |
也就是說,「重複曝光對年長者影響更大」目前是一項仍有爭議的推測,尚未形成一致結論。而 Brashier 與 Schacter 另外指出一個較一致的發現:年長者較容易忘記資訊的來源——這使得事實查核的更正容易淡忘,但原始錯誤訊息因為「讀起來熟悉」而留存[17]。
因此,目前證據支持的是:造成差異的是偏誤機制的運作條件(例如來源記憶、既有習慣),而不是「年紀大所以判斷力差」。
這個區分在實務上很重要。接下來的三種偏誤,在任何年齡層都會運作。數位原住民不會因為熟悉工具就自動免疫——只要碰上符合自己立場或情緒的訊息,每個人都可能跳過查證的步驟。真正的關鍵變數是有沒有養成查證的習慣,而不是年齡。
一、確認偏誤(Confirmation Bias)
定義:人們傾向於接收「符合自身既有期待」的資訊,並對「與既有想法不一致」的資訊採取較嚴格的檢視標準。
| 資訊的性質 | 常見反應 |
|---|---|
| 符合既有想法 | 快速接受,較少質疑 |
| 不符合既有想法 | 要求更多證據,較多質疑 |
這項偏誤的特點是運作時不易察覺。使用者通常感覺自己在進行客觀判斷,但實際上判斷標準已因既有立場而有所不同。
會計工作的對應情境:假設你是公司會計人員,系統跳出一筆異常分錄——
| 簽核者 | 你的既有印象 | 可能的第一反應 |
|---|---|---|
| 資深同事 | 信任 | 「應該是筆誤吧」 |
| 新進同仁 | 陌生、存疑 | 「這個要查一下」 |
同一筆分錄、相同金額、相同的異常幅度——唯一的差別是你對簽核者的既有印象。而這個印象,決定了你會多花五分鐘追查,還是直接核准。
這正是內部控制設計的核心考量:舞弊最容易存在於「我們比較不想懷疑」的地方。這也是為什麼審計準則要求會計師保持職業懷疑——不是因為假設人性本惡,而是因為人的判斷天生會有偏差。
二、可得性捷思(Availability Heuristic)
定義:一件事情的畫面越鮮明、越容易聯想,人們就越容易高估它發生的機率。
運作機制是:系統一判斷「某件事有多常見」時,運用的線索是「我多容易想到它」。而「容易想到」與「實際頻率」未必一致——媒體報導量、畫面震撼度都會影響「容易想到」的程度。
| 情境 | 大腦的感覺 | 實際情形 |
|---|---|---|
| 空難 | 「最近好像很多」 | 飛航仍是相對安全的交通方式之一 |
| 食安事件 | 「這陣子都不敢吃」 | 恐懼程度反映的是媒體曝光量,而非實際風險 |
| 特定疾病 | 「好像很常見」 | 可能受報導頻率影響而高估 |
會計工作的對應情境:假設公司本月的異常損失有兩筆——
| 情況 | 金額 | 受到的關注 |
|---|---|---|
| A | 單筆 800 萬的存貨報廢 | 高——會成為討論焦點 |
| B | 每月固定 2 萬元的零星報廢 | 低——累積一年也是 24 萬,但不易被注意 |
舞弊常見的操作方式之一,是用不顯眼的方式、在較長時間內逐步進行。這也是為什麼查核不能只看「有沒有大筆異常」,而必須搭配趨勢分析與抽樣——因為注意力天生容易被「顯眼」的事物吸引。
三、光環效應與權威偏誤
定義:當一則資訊冠上權威標籤(名校教授、企業高層、知名機構),人們傾向降低查驗的意願。
| 資訊呈現方式 | 常見反應 |
|---|---|
| 「台大教授指出……」 | 較少進一步查證 |
| 「前高盛副總裁分析……」 | 較少進一步查證 |
| 「國際知名投顧研究報告」 | 較少進一步查證 |
這裡需要區分兩件不同的事:
| 概念 | 內容 | 評價 |
|---|---|---|
| 相信專業 | 尊重專業領域的知識累積與方法論 | 合理 |
| 相信標籤 | 因頭銜本身而放棄查驗 | 需要留意 |
判斷的實用原則是:一個真正的專業人士,通常會說明其推論依據與資料來源。而只強調頭銜、不提供可查證依據的陳述,值得進一步確認。
核心命題:權威標籤可以被標示,可查證的證據不行。
捷思的雙面性與偏誤的交互作用
這裡需要補充一個重要的理解:捷思在多數情況下運作良好,它不是需要被消滅的缺陷。
| 情境 | 捷思的作用 | 是否有效 |
|---|---|---|
| 判斷來車速度再過馬路 | 依經驗快速估算 | ✅ 有效 |
| 閱讀熟悉領域的內容 | 快速理解,節省心力 | ✅ 有效 |
| 日常社交互動 | 依經驗快速反應 | ✅ 有效 |
| 判斷一則陌生訊息的來源 | 依「看起來像不像」 | ⚠️ 可能失準 |
那麼,捷思在什麼條件下會產生偏差?
| 條件 | 說明 | 對應本週主題 |
|---|---|---|
| 資訊量遠超處理能力 | 沒有足夠時間逐一分析 | 資訊超載(2.1 節) |
| 情境經過刻意設計 | 有人運用這些機制 | 內容農場、炒作題材 |
| 缺乏回饋機制 | 判斷錯誤不會立即被發現 | 轉傳訊息後通常不知對錯 |
第三項條件特別值得注意。在一般的學習情境中,判斷錯誤通常會很快得到回饋(例如算錯數學題,對答案就知道)。但在資訊判讀的情境中,這個回饋機制往往是缺乏的:
| 動作 | 回饋情形 |
|---|---|
| 轉傳一則不實訊息 | 通常不會有人告知它是錯的 |
| 相信一則假新聞 | 可能長期不知道它是假的 |
| 依據錯誤資訊做決定 | 未必能追溯到原因 |
缺乏回饋,是資訊判斷能力難以自然累積的原因。這也說明了為什麼需要刻意學習一套方法,而不是單靠經驗累積。
三種偏誤的交互作用
三種偏誤並非各自獨立,而是會相互強化。以股市不實題材為例:
| 階段 | 作用的偏誤 | 產生的認知 |
|---|---|---|
| 訊息反覆出現在眼前 | 可得性捷思 | 「好像很多人都在討論這件事」 |
| 出現偽造的「研究報告」 | 光環效應 | 「有機構背書,應該可靠」 |
| 自己已投入資金 | 確認偏誤 | 「這一定是真的」 |
偏誤的組合效果,大於各自單獨作用的總和。
這對「警覺」的啟示
這一點對學習態度有實際意義:
| 想法 | 問題所在 |
|---|---|
| 「我會小心一點就好」 | 警覺本身也會受偏誤影響——自認警覺的人,往往更難察覺自己的偏誤 |
| 「多看幾家報導就好」 | 若多家報導都源自同一則原始訊息,交叉比對的效果有限 |
因此,本週課程強調的是方法,而不只是態度:
| 層次 | 內容 | 特點 |
|---|---|---|
| 態度 | 「要小心查證」 | 需要動機維持 |
| 方法 | 一套固定的操作步驟 | 可重複執行、可傳授 |
SIFT 四步法之所以被廣泛採用,正是因為它是一套方法——不論當下的情緒、立場或疲勞程度如何,都可以照著執行。
如果你真的想到了一個具體例子,那表示你當時的判斷是由系統一主導的。而這節課的目的,就是讓我們在下一次情緒升起的那一秒,能夠多想三秒鐘。這三秒鐘,就是專業判斷與直覺反應的差別。
2.3 生成式 AI 時代的資訊真偽挑戰
我們先建立一個對大型語言模型(LLM,即 ChatGPT 這類工具)的正確認知。常見的理解是「ChatGPT 是一個超級百科全書,裡面存著全世界的知識,你問它,它就去查」。但實際上,LLM 的核心運作方式是機率型的文字生成——它根據訓練時接觸過的大量文字,計算「在某個語境之後,下一個字最可能是什麼」,然後逐字生成。
| 理解方式 | 對應的預期 | 導致的行為 |
|---|---|---|
| 「它是知識庫」 | 「它說的就是查到的資料」 | 直接採用 |
| 「它是文字生成器」 | 「它生成的是最像答案的文字」 | 進一步查證 |
AI 幻覺(Hallucination)
當模型缺乏足夠資料、或提問帶有引導性時,它不會自動表示「我不知道」——它可能生成一段結構完整、語氣自信的內容,其中包含不存在的人名、法規條號、數據,或文獻與案例。
實際案例:在美國曾發生律師使用 AI 工具準備書狀的案例,其引用的法院判例經法官查證後,發現並不存在。該律師與其事務所後續受到法院制裁。
核心命題:AI 陳述的自信程度,與其正確程度沒有必然關係。LLM 的生成機制決定了它的「語氣」來自語言模式,而不是來自「是否查證過」。
在會計領域的應用上,可遵循以下原則:
| 原則 | 說明 |
|---|---|
| 人在迴路(Human in the Loop) | AI 的產出必經專業人員查證 |
| 可驗證性優先 | 優先要求 AI 提供可查證的來源;若無法提供,則需自行查證 |
| 機密資料的界線 | 未公開的財務資料不宜輸入公用 AI 工具 |
深度偽造技術(Deepfake)與合成媒體
| 技術 | 說明 | 門檻 |
|---|---|---|
| 語音克隆(Voice Cloning) | 以少量語音樣本合成特定人物的聲音 | 數秒樣本即可 |
| 人臉置換 | 將影片中的人物面孔替換為他人 | 使用軟體工具 |
| 即時視訊偽造 | 在視訊會議中即時合成影像與聲音 | 技術已可行 |
過去在驗證身分或授權時,「親自通話」或「視訊見面」被視為較強的確認方式——因為當時認為聲音與影像難以偽造。這個前提在生成式 AI 出現後發生了變化:當影像與聲音都可以被合成,「見面即真實」的驗證邏輯需要重新設計。
驗證機制的設計原則
這些原則屬於內部控制的基本要求,並非新創——但生成式 AI 的出現讓它們的重要性更為明確。
| 原則 | 說明 | 具體作法 |
|---|---|---|
| 獨立性 | 確認管道應獨立於請求方 | 以既有登記號碼回撥,不使用對方提供的新號碼 |
| 多重性 | 不依賴單一確認方式 | 大額交易需兩個以上獨立確認 |
| 可追溯性 | 保留完整紀錄 | 書面或系統授權紀錄,含時間、人員、金額 |
| 職權分立 | 不同人員負責不同環節 | 申請、覆核、執行分開由不同人負責 |
| 例外管理 | 特殊情況需額外程序 | 大額、急件、機密案件應有加強程序 |
五項原則中,「獨立性」是最直接對應深偽風險的一項:
| 確認方式 | 是否具獨立性 | 原因 |
|---|---|---|
| 依對方提供的電話號碼回撥 | ❌ 不具 | 該號碼可能由對方控制 |
| 依對方提供的視訊連結加入會議 | ❌ 不具 | 會議內容可能由對方生成 |
| 依公司既有通訊錄的號碼回撥 | ✅ 具 | 該號碼在事件發生前已存在並登記在案 |
獨立性來自「資訊在事件發生前就已存在」,而不是來自「當下的技術有多逼真」。這個原則也解釋了為什麼審計實務要求外部函證——會計師直接發函給銀行,而不是透過受查公司轉交,因為由受查公司提供的文件不具獨立性。
案例:香港 Arup 案
在進入這個案例之前,請先設想一個情境:
你是某跨國企業的財務人員。今天早上,你收到一封郵件,寄件者顯示是英國總部的財務長(CFO),內容提到有一筆需要保密的收購案,請你協助處理匯款。
你的第一反應是——這可能是釣魚郵件。於是你謹慎地回覆詢問,對方隨即邀請你參加一場視訊會議。
會議開始了。螢幕上有財務長,還有兩位你在倫敦總部認識的同事。他們的長相、說話的口音、開會時的小動作,都跟你印象中一模一樣。財務長在會議中指示你:「這是一筆極機密併購案,請立即執行匯款。」
現在,你會懷疑嗎?
這不是模擬題,而是 2024 年 1 月真實發生在香港的一起案件。以下為事件經過:
| 階段 | 內容 |
|---|---|
| 背景 | 2024 年 1 月,英國跨國工程顧問公司 Arup 的香港財務部門職員,接獲一封自稱來自英國總部財務長(CFO)的郵件,內容要求執行一筆需要保密的收購匯款 |
| 初始警覺 | 該職員起初已察覺郵件可疑,懷疑是釣魚郵件 |
| 視訊會議 | 隨後被安排參加一場多人視訊會議,會中除他本人外,其他與會者均為以其公開影音素材合成的 Deepfake 影像 |
| 判斷改變 | 因會議中「其他同事也在場」,判斷此筆交易已獲得確認 |
| 執行匯款 | 分 15 次匯出 HK$2 億(約 US$2,560 萬) |
| 事後發現 | 向總部查證後,確認並無該場會議與該筆授權。Arup 於 2024 年 5 月對外說明此案[8] |
這起案例的核心,不在於技術本身,而在於一個內控環節被技術突破:當「主管授權」這個步驟可以被技術複製時,內控流程需要設計成不依賴單一感官確認的機制。
| 原則 | 具體作法 |
|---|---|
| 不依賴單一管道 | 視訊之外,另以既有登記號碼回撥確認 |
| 不依賴單一人員 | 大額交易需雙人獨立覆核 |
| 保留可追溯紀錄 | 授權須有書面或系統紀錄 |
| 建立例外處理 | 大額、急件、機密案件應有額外程序 |
假圖辨識實作 — 五角大廈事件
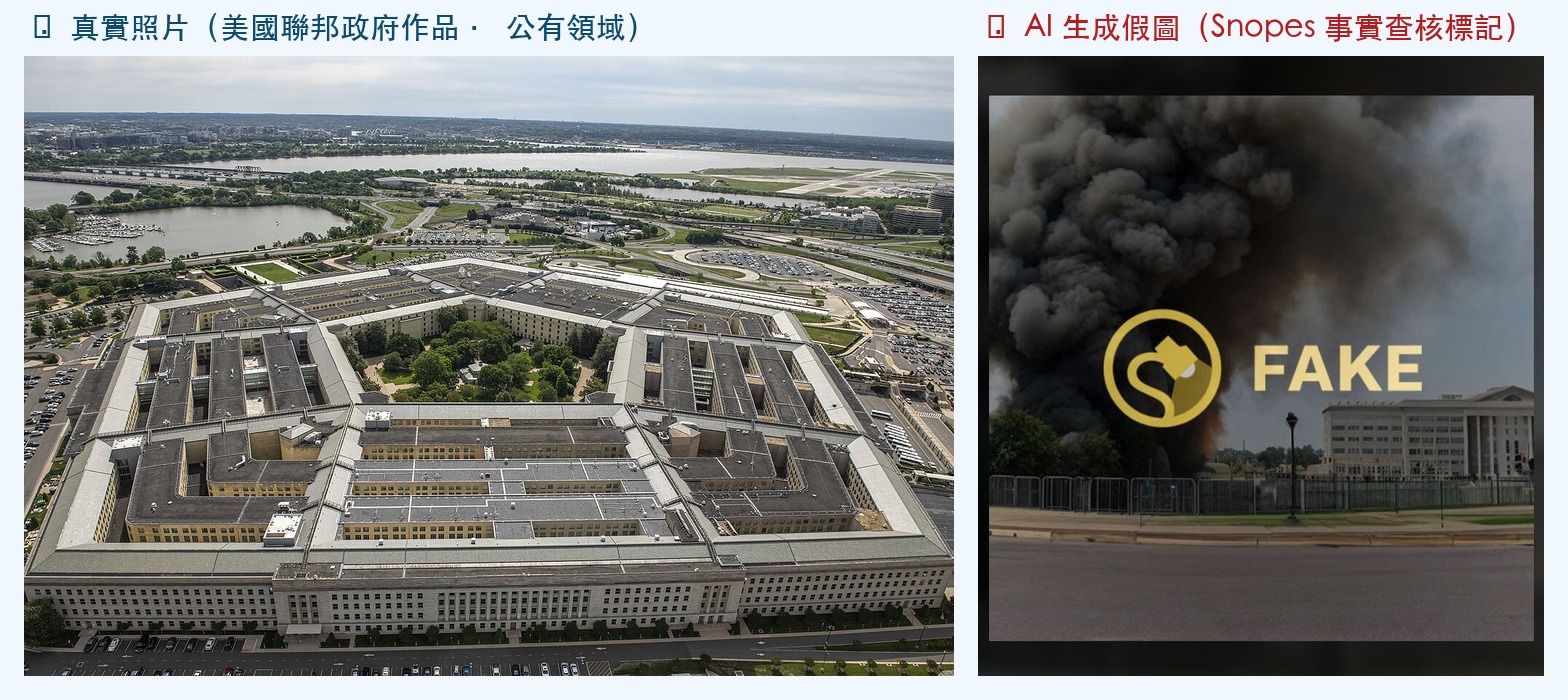
事件背景:2023 年 5 月 22 日,社群平台 X(當時名為 Twitter)出現一張影像,畫面為美國國防部五角大廈附近出現大量濃煙,看起來像是發生爆炸。該影像經若干具認證標記的帳號轉發。
| 時間 | 事件 |
|---|---|
| 當日 | 影像開始流傳 |
| 當日 | 美國國防部(PFPA)與阿靈頓郡消防局出面澄清,並無此事[9] |
| 當日 | 訊息一度影響市場交易,標普 500 指數短暫下跌約 0.3%(各方數據為 0.26%),隨後迅速回升[9] |
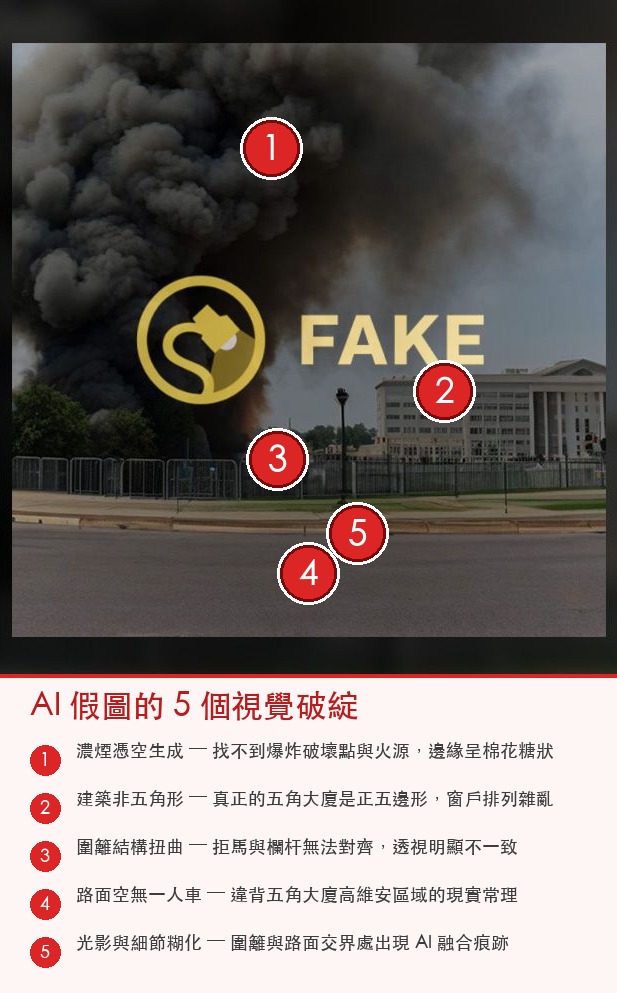
五處視覺特徵(請搭配下圖解說):
| # | 特徵 | 說明 |
|---|---|---|
| 1 | 濃煙與場景關聯不明 | 找不到對應的破壞點與火源,煙霧邊緣質感過於均勻 |
| 2 | 建築形狀不符 | 五角大廈為正五邊形建築,圖中建築為一般長方形 |
| 3 | 圍籬結構不連續 | 拒馬與欄杆的對齊與透視不一致 |
| 4 | 場景空曠 | 與該區域的實際使用狀況不符 |
| 5 | 細節融合 | 圍籬與路面交界處有影像融合的痕跡 |
三招通用檢查點
| 檢查點 | 具體作法 |
|---|---|
| 重複性結構檢查 | 查看欄杆、窗戶、磚牆、鍵盤等重複且需對齊的結構——這是影像生成較常出現問題的地方 |
| 常理檢查 | 檢視場景在現實中是否合理(例如高維安區域是否可能完全空曠) |
| 邊界檢查 | 查看兩個元素交界處(髮際與背景、手指與物件)是否清楚 |
補充說明:社群平台的認證標記(藍勾勾)在現行制度下可付費取得,其意義與「官方認證」不同。因此,判斷時宜以內容本身與來源查證為依據。
這一段的目標是讓各位具備初步的影像判斷能力。但同時要建立一個重要的理解:影像生成技術持續精進,肉眼辨識的可靠度會逐步下降;可長期依靠的是查證方法。這也是為什麼下一節要學的是方法(SIFT),而不只是辨識技巧。
AI 工具在會計領域的應用場景
理解了技術特性之後,可以進一步看它在會計領域的實際應用,這有助於建立「工具與查證並用」的工作方式。
| 應用 | 說明 | 查證環節 |
|---|---|---|
| 財報摘要與解讀 | 快速整理大量財報內容 | 摘要的正確性需人工確認 |
| 差異分析初稿 | 產生初步的差異原因假設 | 假設需以實際資料驗證 |
| 法規查詢輔助 | 協助定位相關法規條文 | 條號與內容需核對官方版本 |
| 文件草擬 | 產生說明文件、備忘錄初稿 | 內容與數據需覆核 |
| 資料整理 | 結構化非結構化資料 | 格式與完整性需檢查 |
關於「機密界線」這一項,與第 1 週的數位足跡、本節前面的資料治理相互呼應:
| 資料類型 | 建議處理方式 |
|---|---|
| 已公開資訊 | 可依公司規範使用 |
| 內部管理資料 | 需依公司規範評估 |
| 未公開財務資料 | 不宜輸入公用 AI 工具 |
| 客戶個人資料 | 需符合個人資料保護相關規範 |
使用 AI 工具的效率提升,不改變會計專業對資訊正確性與保密性的基本要求。本週建立的是使用原則;第 4 週「AI 基礎與倫理」會進一步處理 AI 幻覺與偏見的成因,以及智慧財產權與專業倫理準則。
對會計專業作業流程的影響
憑證核驗的挑戰
本節前面提到的深偽技術,主要影響的是「人的身分確認」。但生成式 AI 對會計工作的另一項影響,是憑證本身。
會計的核心工作是依據憑證做判斷。過去辨識假發票,可以看紙質、看印刷、看印章的細節——但這些物理特徵在數位檔案裡完全不存在。而 AI 可以生成高度擬真的:發票、銀行水單、授權公文。
| 傳統作法 | 遭遇的挑戰 | 調整方向 |
|---|---|---|
| 檢視紙本憑證的物理特徵(紙質、印刷、印章) | 數位檔案缺乏這些特徵 | 需以系統紀錄與外部來源交叉驗證 |
| 核對單據內容一致性 | 擬真度可極高 | 需比對獨立第三方資料 |
實務上:書面核對需搭配獨立來源的確認。這與下一節要學的橫向閱讀、以及審計實務的外部函證,是同樣的邏輯。
內部控制設計的調整
| 項目 | 過去的作法 | 調整方向 |
|---|---|---|
| 授權確認 | 通話或視訊確認 | 以既有登記號碼回撥、雙人覆核 |
| 憑證查驗 | 書面核對 | 系統紀錄交叉比對 |
| 大額交易 | 單一管道核准 | 多重獨立確認 |
內部人舞弊方面:因熟悉流程、具備人際信任基礎,內部人舞弊向來是內控設計的重點項目。這也回應了 2.2 節提到的確認偏誤——舞弊常存在於「較不會被懷疑」的環節。
2.4 專業查證思維與數位工具箱
請先設想一個情境:你收到一個連結,點進去是一個看起來相當專業的網站,內容提到一個投資機會。你的第一個反應是什麼?
多數人的作法是留在這個頁面,往下滑——看排版是否精美、看「關於我們」寫得是否認真、看有沒有客戶見證、看是否使用專業術語。看完之後判斷「做得滿精緻的,應該是可信的」。
這個方法在事實查核領域稱為「縱向閱讀」(Vertical Reading)——你停留在同一個頁面內,向下深入。專業查證人員的作法則相反,稱為「橫向閱讀」(Lateral Reading):不要往下滑,立刻另外開啟分頁,去查詢「這個來源是什麼?獨立媒體怎麼說它?」
也就是說:不是問「這個網站看起來可不可信」,而是問「別人怎麼說這個網站」。
橫向閱讀的實證依據
這套方法有實證研究支持。Wineburg 與 McGrew(2019)在《Teachers College Record》發表的研究中,比較了三組受試者[10]:
| 受試者 | 使用的策略 | 判斷表現 |
|---|---|---|
| 25 名大學生 | 縱向閱讀為主 | 較容易判斷錯誤 |
| 10 名歷史學博士 | 縱向閱讀為主 | 較容易判斷錯誤 |
| 專業事實查核員 | 橫向閱讀 | 判斷最準確,且花費時間最短 |
這項結果的意義是:判斷的準確度,與「讀得多不多」關係不大,而與「有沒有跳出去查」關係較大。
為什麼縱向閱讀效率較低?有一個實務上的原因:專業的網站製作成本相當低。詐騙網站或內容農場的排版與文案,可能比政府機關網站更精美。因此,「用外觀判斷可信度」是一項效率較低的方法。
SIFT 四步法
SIFT 由數位素養研究者 Mike Caulfield 於 2019 年提出[11],已被廣泛採用於圖書館、大學與新聞編輯室的資訊素養訓練。它的優點是步驟明確、可在一分鐘內完成。
| 步驟 | 英文 | 中文 | 具體動作 |
|---|---|---|---|
| S | Stop | 停下來 | 察覺強烈情緒或準備轉發時,先暫停 |
| I | Investigate the source | 調查來源 | 檢視發布主體的資格、網域、過往紀錄 |
| F | Find better coverage | 尋找更佳報導 | 查看是否有獨立、權威的來源刊載相符報導 |
| T | Trace claims | 追溯原始脈絡 | 回溯至原始資料、原始發言或原始檔案 |
S — Stop(停下來)
| 項目 | 說明 |
|---|---|
| 時機 | 感受到強烈情緒時(氣憤、震驚、興奮),或準備按轉發時 |
| 動作 | 暫停三秒 |
| 認知基礎 | 強制啟動系統二(見 2.2 節) |
| 實務作法 | 深呼吸一次,或將手指移開轉發鍵 |
I — Investigate the source(調查來源)
| 問題 | 檢查重點 |
|---|---|
| 發布主體是誰? | 是否有具名負責人、是否為匿名帳號 |
| 網域是什麼? | .gov.tw(政府)、.edu.tw(學校)、.org.tw(機構),或其他 |
| 過往紀錄如何? | 該來源過去發布的內容品質,是否曾被獨立媒體引用 |
重點是:這個步驟不要在原網站內進行,要跳出去查詢——這就是橫向閱讀。
F — Find better coverage(尋找更佳報導)
| 作法 | 說明 |
|---|---|
| 查詢主流媒體 | 是否有彭博、路透、中央社等報導同一事件 |
| 查詢查核機構 | 是否有事實查核組織已處理過此訊息 |
| 判斷原則 | 若某項重大消息僅有單一來源,值得進一步查證 |
T — Trace claims to original context(追溯原始脈絡)
| 作法 | 說明 |
|---|---|
| 找原始數據 | 若引述研究,去找該研究本身 |
| 找完整發言 | 若引述某人說法,去看完整逐字稿或原始影片 |
| 用反向圖片搜尋 | 確認圖片最早出現的時間與位置 |
這一步的價值在於:可辨識出「內容為真,但脫離原情境」的情形(即 2.1 節介紹的「惡意資訊」)。
數位查證工具
圖片反向搜尋
| 工具 | 使用方式 |
|---|---|
| Google Lens | 手機 Google App 內建,將圖片存入後搜尋 |
| TinEye | 網頁版,可查詢圖片在網路上的出現紀錄 |
功能是顯示圖片的最早出現時間與位置,可辨識「舊照片搭配新標題」的手法——這是常見的資訊錯置方式。
事實查核組織
| 組織 | 特性 |
|---|---|
| 台灣事實查核中心(TFC) | 台灣取得國際事實查核聯盟(IFCN)認證的組織;自 2018 年首度取得認證後持續獲認證;查核報告公開查證方法[12] |
| MyGoPen(麥擱騙) | 處理常見於通訊軟體轉傳的訊息,包括健康、食安、政策類 |
實用建議:可將這兩個網站加入書籤。當遇到親友轉傳的可疑訊息時,回傳查核報告的連結,通常比直接爭辯更有效。
網域識別
| 網域結尾 | 意義 |
|---|---|
.gov.tw | 政府機關官方網站 |
.edu.tw | 學校機構 |
.org.tw | 財團法人、協會等機構 |
| 其他結尾 | 需進一步查證 |
檢查技巧:從網址結尾往前看。先看最後一段(.tw、.com、.cc),再看主要網域名稱。有些網址會將相似字串放在中間,快速掃視時不易察覺。
會計專業的官方管道原則
這一段是本週課程與會計專業最直接的連結。
核心原則:只有出現在「法定揭露管道」的資訊,才具備法律效力與採信價值。
| 國家/地區 | 平台 | 說明 |
|---|---|---|
| 台灣 | 公開資訊觀測站(MOPS) | 由臺灣證券交易所維護 |
| 美國 | SEC EDGAR | 美國證券交易委員會的電子申報系統 |
上市櫃公司的重大訊息(財報、重大合約、高層人事變動、併購案等),依法須在這些平台公告。因此,當聽到一則關於某上市公司的重大消息時,判斷方式很明確:
| 查詢結果 | 判斷 |
|---|---|
| MOPS 有公告 | 可進一步了解內容 |
| MOPS 無公告 | 該消息不具法定揭露地位 |
這正是會計思維的特點:不依賴感官判斷,而依賴制度與可查證的來源。
審計實務的對應:外部函證
| 項目 | 說明 |
|---|---|
| 作法 | 會計師直接發函給銀行或供應商,請對方確認餘額或交易 |
| 為什麼要繞過受查公司 | 因為受查公司提供的文件需要獨立驗證 |
| 與 SIFT 的關聯 | 兩者都是「不依賴轉述,直接找獨立的第一手來源」 |
查證場域:電子商務與資料治理
前面的方法與工具是通用的。以下說明它們在實務場域的應用。
教科書第 2 章介紹了電子商務依交易雙方區分的五種型態[1]:
| 型態 | 全稱 | 中文 | 交易雙方 |
|---|---|---|---|
| B2B | Business to Business | 企業對企業 | 企業 ↔ 企業 |
| B2C | Business to Consumer | 企業對消費者 | 企業 ↔ 消費者 |
| C2C | Consumer to Consumer | 消費者對消費者 | 消費者 ↔ 消費者 |
| C2B | Consumer to Business | 消費者對企業 | 消費者 ↔ 企業 |
| O2O | Online to Offline | 線上對線下 | 線上平台 ↔ 實體服務 |
這些型態與查證能力的關聯如下:
| 型態 | 需要查證的應用場景 |
|---|---|
| B2C | 辨識要求輸入帳密的偽造通知 |
| C2C | 辨識賣家與評價的真實性 |
| B2B | 確認交易對象與帳戶變更的正確性(與 Arup 案相關) |
| O2O | 確認線上資訊與實體服務的一致性 |
教科書也介紹了智慧城市的六大指標[1]:智慧經濟(smart economy)、智慧治理(smart governance)、智慧環境(smart environment)、智慧居民(smart people)、智慧交通(smart mobility)、智慧生活(smart living)。其中「智慧治理」的核心,即為資料治理——城市的運作建立在資料的正確性與權限管理之上。
數位化程度越高的社會,對資訊正確性的依賴也越高。
各位有沒有發現,你剛才做的事情,跟平常看訊息的方式不太一樣?平常是「看著它,判斷它可不可信」;但剛才你是「跳出去,找別人的說法」。這就是橫向閱讀。
2.5 實戰演練:假新聞偵探
本節為課堂活動,以學生實作與討論為主。以下為活動規則與四個案例的完整說明。
⏱ 兩堂課切分點提示:第一堂課為 2.1 至 2.3;第二堂課自 2.4 開始,接續本節 2.5 實戰演練。
活動概述與規則
| 項目 | 內容 |
|---|---|
| 活動名稱 | 🧩 假新聞偵探 |
| 案例數 | 4 則擬真情境 |
| 總時間 | 20 分鐘 |
作答選項說明(重要)
四個案例共用作答選項。其中案例四的性質與其他三題不同——它的數據本身沒有造假,問題出在呈現方式,因此需要第三個選項:
| 選項 | 說明 |
|---|---|
| ✅ 真實 | 內容正確、來源可信 |
| ❌ 虛假 | 內容不實或來源偽造 |
| ⚠️ 視覺誤導 | 數據未造假,但呈現方式造成誤解 |
案例一:圖文錯置型社群快訊(模擬教學案例)
情境:X(Twitter)上出現一則貼文,發布者具認證標記。內容為「突發:ASML 荷蘭廠發生特大火災,產線全面停擺」,並附上一張濃煙沖天的空拍照片。
說明:本案例為模擬教學案例,情境與圖文為教學目的所設計,用以練習「圖文錯置」這類手法的辨識方式。以下解析中的查證動作,是在真實情境中應該依序執行的方法。
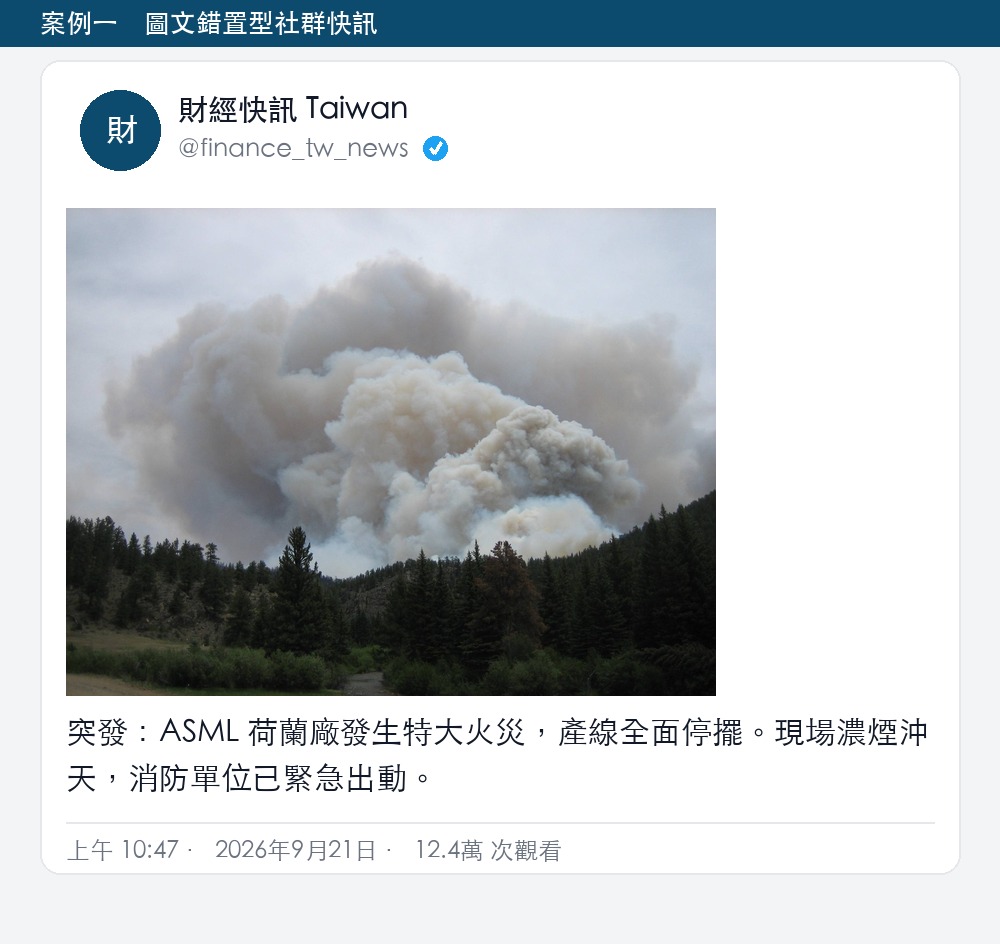
請注意這則貼文的三個特徵:發布者帶有認證標記、內容涉及知名企業的重大事故、附有視覺衝擊強烈的照片。先不要急著判斷真假,先問自己:這三個特徵,各自應該用 SIFT 的哪一步來查?
公布答案與推論依據
答案:虛假
| # | 推論依據 | 對應的 SIFT 步驟 |
|---|---|---|
| 1 | 認證標記現可付費取得,不代表內容經過審核 | I(調查來源) |
| 2 | 查詢主流媒體,未見相關報導——ASML 為歐洲重要科技公司,其廠區重大事故應會成為國際財經新聞 | F(尋找更佳報導) |
| 3 | 將照片送入反向圖片搜尋,發現該圖在多年前的其他事件報導中已出現過,並非本次事件的照片 | T(追溯原始脈絡) |
這則案例同時使用三種手法:使用可付費取得的認證標記(營造可信度)、使用真實的災難照片(產生視覺衝擊)、選擇知名企業為目標(提高關注度)。而我們用三個不同的方法分別辨識出來——這說明了 SIFT 四個步驟各有其功能。
案例二:AI 生成人物與假專家背書
情境:一張財經雜誌封面,人物標示為「高盛前總裁 Dr. Clarissa Wood(虛構人物)」,標題為「獨家專訪:保證年化收益 38.5% 的投資組合」。
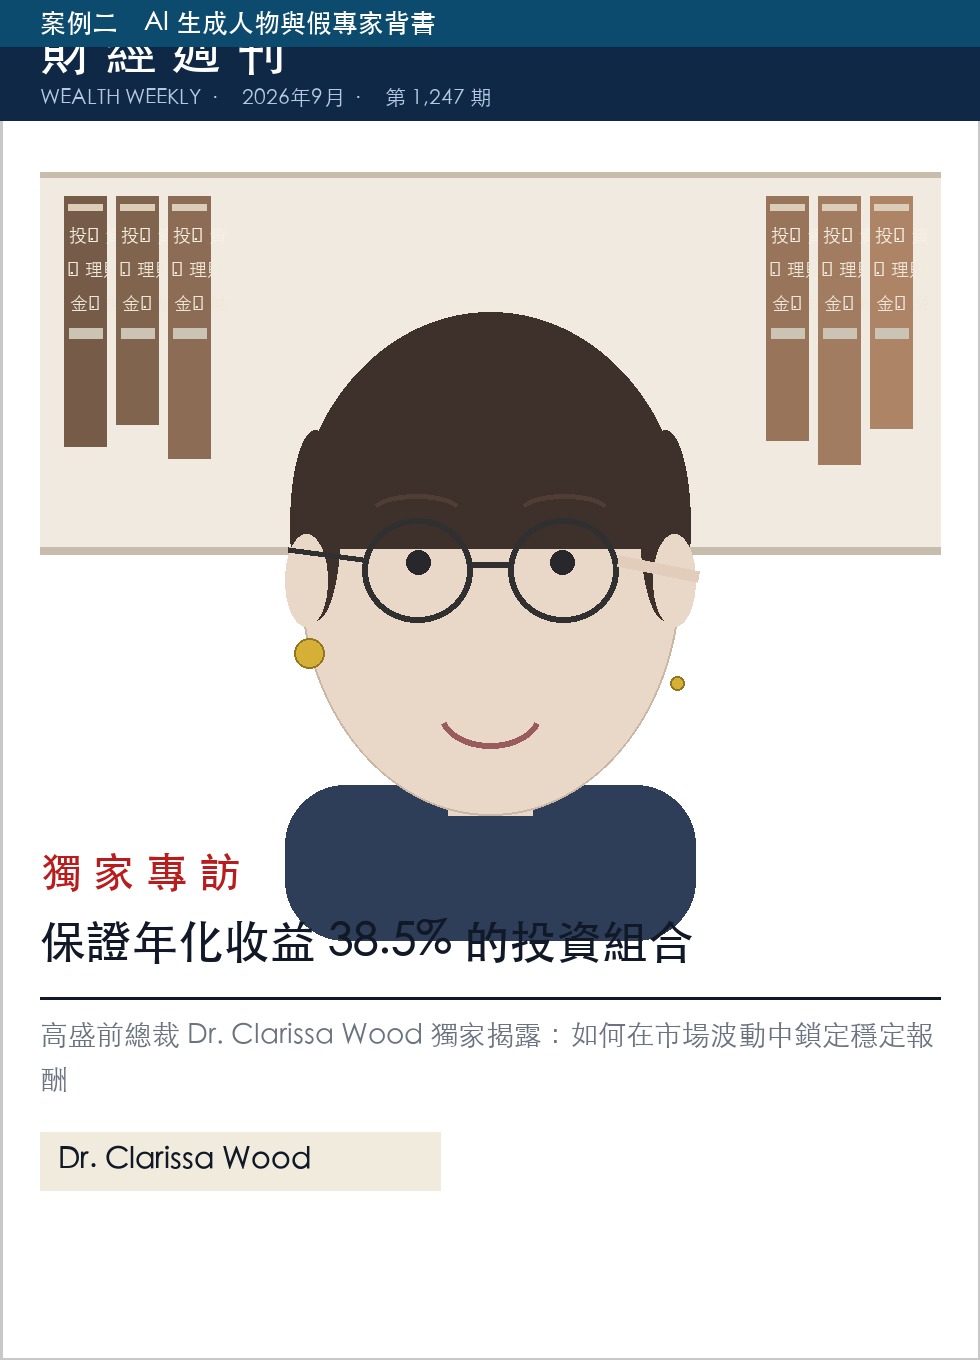
這一題的破綻有三個層次,而且需要的工具各不相同。請先看第一層:這張照片本身有沒有問題?特別注意人物的飾品、眼鏡與背景文字。
公布答案與推論依據
答案:虛假
層次一:視覺特徵(AI 生成痕跡)
| # | 特徵 | 對應的檢查點 |
|---|---|---|
| 1 | 左右耳環不對稱 | 重複性結構 |
| 2 | 眼鏡鏡腿與皮膚融合 | 邊界檢查 |
| 3 | 背景書架上的書脊文字扭曲 | 文字生成(AI 較不擅長處理文字) |
層次二:來源查證(具體查法)
| 查證動作 | 結果 |
|---|---|
| 在 LinkedIn 搜尋「Clarissa Wood」 | 查無此人的專業檔案 |
| 至 Goldman Sachs 官網的領導團隊頁面查核歷任高階主管 | 未見此名 |
| Google 搜尋「Clarissa Wood Goldman Sachs」 | 無任何獨立媒體報導 |
補充說明:「高盛前總裁」是可以查證的公開身分——投資機構的高階主管姓名為公開資訊。真正的專業人士,其經歷可在多個獨立來源中交叉驗證。
層次三:專業常理
高收益與「保證無風險」並存,與財務基本原理不符。在財務理論中,報酬與風險具有對價關係;追求較高報酬,需承擔相應風險。
| 敘述 | 判斷 |
|---|---|
| 「保證年化 38.5%,零風險」 | 與財務基本原理不符 |
這一題的三個層次值得注意:視覺特徵需要辨識技巧(2.3 節所學)、來源查證需要橫向閱讀(本節所學)、而專業常理不需要任何工具,只需要專業知識——這正是各位的專業優勢所在。
案例三:偽造政府機關公文
情境:一份政府機關公文(含機關名稱、印記、發文字號),內容為「為防範洗錢,請民眾於本平台核驗網銀身分,以維護帳戶安全」,並附上一個網址連結。
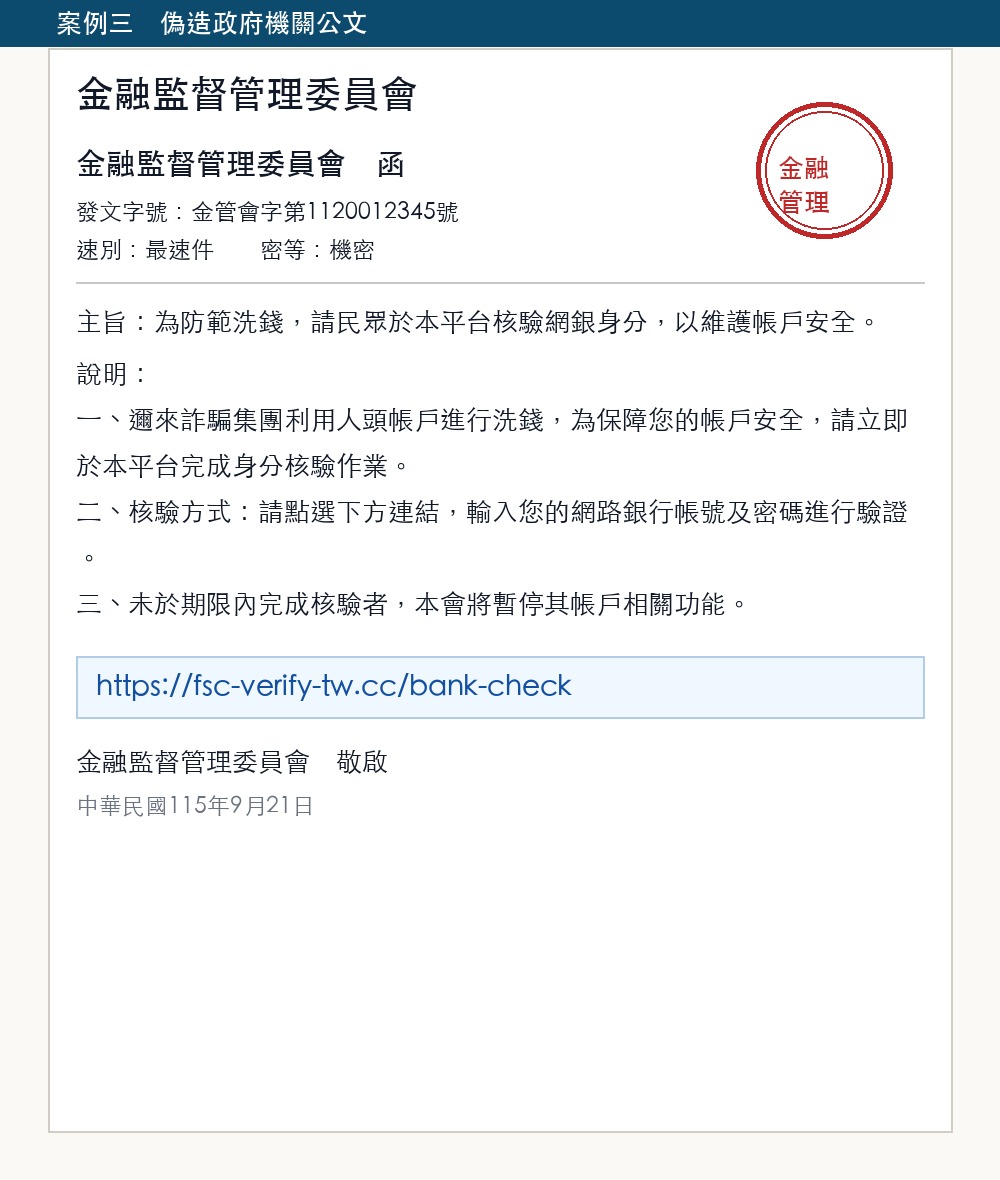
這一題的破綻不只一個。請在時限內盡量找出:這份公文有幾個地方不對?提示:先看網址,再看用字,最後想一個問題——政府機關會需要你的網銀密碼嗎?
公布答案與推論依據
答案:虛假
| # | 破綻 | 檢查方式 |
|---|---|---|
| 1 | 網域不符 | 連結網址結尾為 .cc,非政府機關的 .gov.tw |
| 2 | 用字異常 | 內容可見簡繁轉換痕跡(例如部分字的字形為簡體字轉換結果),用詞也不符合台灣公文習慣 |
| 3 | 字號格式 | 台灣公文發文字號有固定格式(如「金管會字第 1120012345 號」),該文件格式不符 |
| 4 | 行政常理 | 政府機關不會要求民眾在非官方連結輸入網銀帳密 |
關於第四點:政府機關不需要民眾的網銀密碼。金融監理機關如需查核,可透過金融機構的申報系統取得資料,不需要請民眾自行上傳。因此,任何要求「點擊連結、輸入帳號密碼以驗證身分」的通知,都需要高度警覺。
值得注意的是:四個破綻中,「網域不符」與「行政常理」這兩項不需要任何工具——基本的數位常識就能處理相當比例的風險。
案例四:比例刻意扭曲之財報趨勢圖
情境:一份上市公司財報簡報中的一頁,圖表標題為「本公司淨利潤成長趨勢」,折線呈現近乎垂直上升。
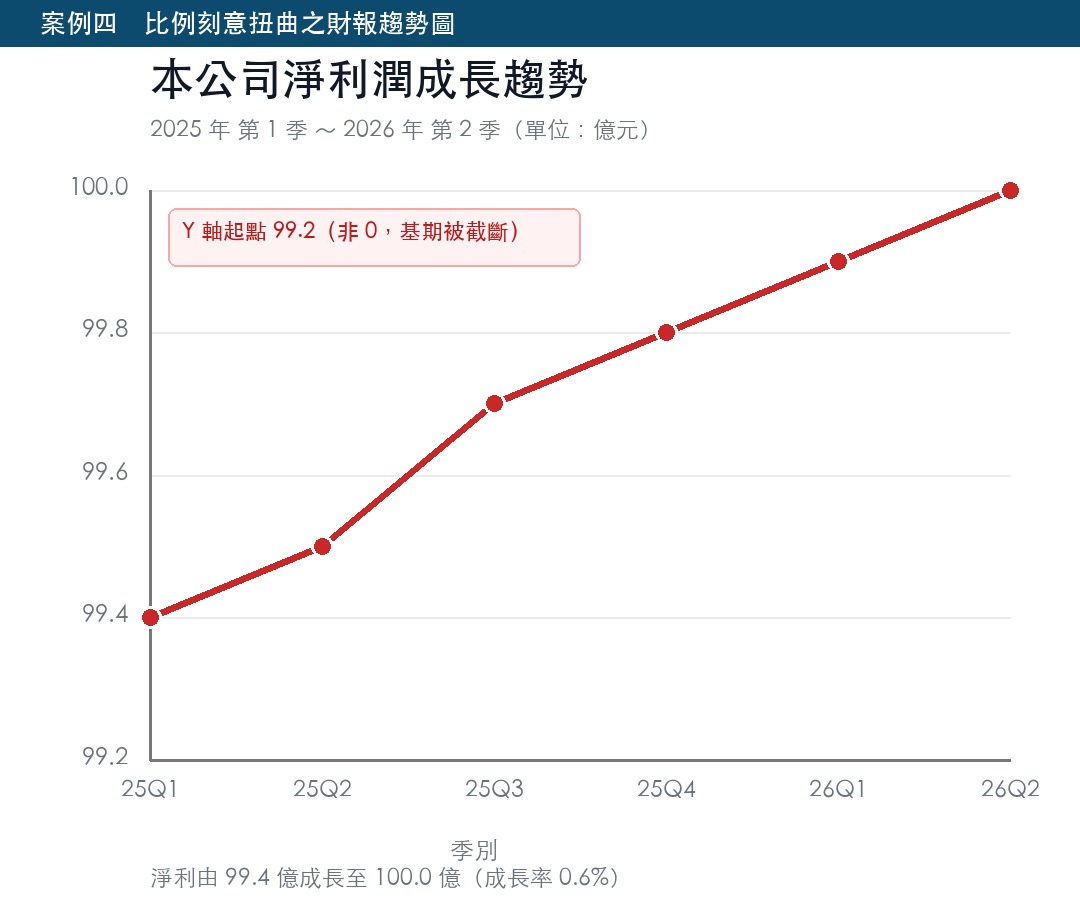
這一題請各位會計系的同學特別注意。先看那條線,再看 Y 軸——這張圖的數字有沒有造假?如果沒有,那問題在哪裡?
公布答案與推論依據
答案:視覺誤導(圖表數據本身未造假,但呈現方式造成誤解)
關鍵在 Y 軸:
| 項目 | 數值 |
|---|---|
| Y 軸起點 | 99.2 億(而非 0) |
| 實際淨利變化 | 由 99.4 億增至 100 億 |
| 實際成長率 | 0.6% |
0.6% 的成長,因為 Y 軸截斷,呈現為近乎垂直的上升線。
核心命題:圖表本身不會說謊,但製圖者可以選擇座標軸的起點。這種手法稱為「Y 軸截斷」,其特點是不需要修改任何一個數字,只需調整座標軸的起點。
這類手法常見於企業財報、投資說明會與法人說明會的簡報中。因此,檢視圖表時應注意:
| 檢視項目 | 具體問題 |
|---|---|
| Y 軸起點 | 從哪裡開始?是否為 0? |
| 單位 | 是億元、千元,還是百分比? |
| 比較基礎 | 與去年同期比,還是與上一季比? |
| 成長率計算 | 分母是什麼? |
| 製圖者 | 這份圖表是誰製作的?對誰有利? |
查核財報不能只看圖像表面,必須檢視底層的數據邏輯。非專業者關注的是結論(「成長好快」);專業者關注的是方法(「Y 軸從哪裡開始?」)。
活動總結
| 案例 | 主要手法 | 對應的辨識方法 |
|---|---|---|
| 一 | 圖文錯置(真照片配假事件) | 反向圖片搜尋 + 橫向閱讀 |
| 二 | AI 生成人物假背書 | 視覺特徵 + 來源查證 + 專業常理 |
| 三 | 偽造官方公文 | 網域檢查 + 行政常理 |
| 四 | 視覺比例誤導 | 檢視底層數據邏輯 |
四個案例的手法不同,但辨識方法都指向同一件事:離開原頁面、尋找原始來源、核對可驗證的資料。這就是 SIFT 的核心精神。
最後補充一點。如果剛才有人用 AI 工具查到答案,為什麼不算數?原因有兩個:第一,本活動要練的是「怎麼查」,而不是「查到什麼」——直接把問題丟給 AI,等於跳過了整個練習過程。第二,AI 工具同樣可能出錯(如 2.3 節說明的幻覺現象),而且它不會告訴你判斷的依據。在專業工作裡,能說明依據的結論,才有採信的價值。
2.6 總結與會計專業思維建立
先說明一個可能與直覺不同的觀點:會計的核心不只是記帳。記帳是技術與工具;而會計專業服務的核心價值是「信任(Trust)」。
在會計學理中,財務報表必須呈現「真實與公允之表達」(True and Fair View,我國實務譯為「允當表達」)——這是我們這個專業對社會的承諾。而「真實」與「公允」這兩個詞,正是本週所學「查證」能力在專業上的對應。
| 環節 | 說明 |
|---|---|
| 資本市場的運作 | 投資人願意將資金投入未曾親訪的公司,建立於對財務報表的信任 |
| 信任的來源 | 有一群會計專業人員,以嚴謹的程序確認那些數字 |
| 結論 | 會計專業是這份信任的維護者 |
職業懷疑心(Professional Skepticism)
依國際審計準則 ISA 200 的定義[13]:
這句話裡有一項重要的平衡:既不假定管理當局是欺瞞的,也不假定他們是毫無疑問誠實的。
| 立場 | 說明 |
|---|---|
| 不是「懷疑所有人」 | 那不是專業懷疑,而是預設立場 |
| 不是「相信所有人」 | 那不需要專業判斷 |
| 而是「不先預設,而是要求證據」 | 這才是職業懷疑心的核心 |
與 SIFT 的對應關係
| SIFT 步驟 | 對應的專業態度 |
|---|---|
| Stop | 客觀性——不讓情緒影響判斷 |
| Investigate | 評估證據的可靠性 |
| Find | 尋找獨立第三方的確認(外部函證的精神) |
| Trace | 回溯至原始憑證(查核的起點) |
核心命題:SIFT、橫向閱讀與反向圖片搜尋,本質上是數位時代的「職業懷疑心」。這些方法不是額外的技能,而是同一種專業態度在不同媒介上的應用。
兩個案例的啟示
一、美聯社社群帳號遭駭事件(2013/04/23)
| 項目 | 內容 |
|---|---|
| 事件 | 美聯社的社群帳號被盜用,發布一則關於白宮爆炸的不實貼文 |
| 市場反應 | 自動交易系統依關鍵字觸發賣出指令 |
| 影響 | 約 3 分鐘內,標普 500 指數市值一度減少約 1,365 億美元,隨後回升(Reuters 數據)[14] |
| 後續 | 白宮澄清後,市場回升 |
訊息即使只存在約 3 分鐘,仍足以在市場上造成可觀的價格影響。這說明了資訊正確性與金融市場運作之間的直接關聯。
二、維基百科「比喬林衝突」虛構條目(2007-2013)
| 項目 | 內容 |
|---|---|
| 事件 | 2007 年出現一則條目,記述 1640 年代的一場戰爭 |
| 規模 | 約 4,500 字,附有大量引用文獻 |
| 存在時間 | 五年 |
| 評價 | 曾獲「優良條目」評價 |
| 揭露 | 2013 年經查核發現,該戰爭不存在,所有引用的書籍與作者均為虛構[15] |
| 後續 | 條目已刪除 |
形式的完整(字數充足、附有註腳、排版規範)與內容的正確,是兩件需要分別確認的事。這也呼應了 2.1 節羅斯柴爾德案例的啟示:來源的權威性,不能取代對原始證據的查證。
本週在課程地圖中的位置
| 週次 | 主題 | 與本週的關係 |
|---|---|---|
| 第 1 週 | 數位世界入門 | 建立數位環境的基本認識;本週在此基礎上處理「判讀」能力 |
| 第 2 週 | 資訊素養與判斷力 | 建立查證方法(本週) |
| 第 4 週 | AI 基礎與倫理 | 從「辨識他人產出」進到「自己使用 AI 的界線」 |
| 第 8 週 | 通訊網路與網際網路應用 | 將本週的驗證原則應用於技術實作(零信任架構) |
| 第 13 週 | 數位時代的會計專業 | 將查證能力連結至審計、稅務、財務的實務應用 |
本週建立的能力會在後續課程持續使用:SIFT 四步法可用於所有週次的資料查找與確認;橫向閱讀可用於產業案例研究與文獻查證;法定揭露管道的概念會在成本效益分析(第 12 週)與數位時代的會計專業(第 13 週)中再次出現;資料治理概念會延伸至資料庫與大數據(第 14 週)。
下一週預告:下一週(第 3 週)為教師節放假。再下一次上課為第 4 週,主題為「AI 基礎與倫理」,內容包括生成式 AI 原理、提示詞工程基本概念、AI 幻覺與偏見(延伸本週 2.3 節),以及智慧財產權與專業倫理。
本週核心命題回顧
| # | 命題 |
|---|---|
| 1 | 資訊社會的兩個條件是「環境」與「能力」——本週處理的是能力 |
| 2 | 內容推薦系統排序的是「互動程度」,而非「客觀真實性」 |
| 3 | 查證是「刻意啟動系統二」的動作(SIFT 的 S 步驟) |
| 4 | 權威標籤可以被標示,可查證的證據不行 |
| 5 | AI 陳述的自信程度,與其正確程度沒有必然關係 |
| 6 | 來源的權威性,不能取代對原始證據的查證(SIFT 的 T 步驟) |
| 7 | 只有出現在法定揭露管道的資訊,才具備法律效力與採信價值 |
| 8 | 查核財報不能只看圖像表面,必須檢視底層的數據邏輯 |
| 9 | SIFT 與橫向閱讀,本質上是數位時代的職業懷疑心 |
答案會更新,工具會演進,資訊生成技術會持續精進。但一套嚴謹的查證方法,可以長期使用——這就是專業能力可持續的基礎。
2.7 本週重點提煉與自我評量
重點提煉
| 節 | 核心概念 |
|---|---|
| 2.1 | 資訊社會的兩個條件;資訊超載;推薦系統的排序依據;資訊失真三型態;資料的生命週期 |
| 2.2 | 雙系統思維;三種認知偏誤;捷思的雙面性;查證是刻意啟動系統二 |
| 2.3 | LLM 的生成本質;AI 幻覺;深度偽造;驗證機制的設計原則;影像檢查點 |
| 2.4 | 橫向閱讀;SIFT 四步法;數位查證工具;法定揭露管道;外部函證 |
| 2.5 | 四種資訊問題類型與對應的辨識方法 |
| 2.6 | 職業懷疑心;兩個案例的啟示;本週在課程地圖中的位置 |
自我評量
| # | 題目 | 對應節次 |
|---|---|---|
| 1 | 請說明「資訊社會」的定義包含哪兩個條件。 | 2.1 |
| 2 | 為什麼內容推薦系統的排序依據與「真實性」不同? | 2.1 |
| 3 | 請舉一例說明「確認偏誤」在日常判斷中的運作。 | 2.2 |
| 4 | 為什麼「查證」需要刻意啟動系統二? | 2.2 |
| 5 | 請說明 LLM 的生成機制與「AI 幻覺」的關係。 | 2.3 |
| 6 | 為什麼「視訊見面」不再能作為授權的充分確認? | 2.3 |
| 7 | 請寫出 SIFT 四個步驟的英文與中文。 | 2.4 |
| 8 | 台灣上市公司的重大訊息,應至哪個平台查詢? | 2.4 |
| 9 | 為什麼「Y 軸截斷」會造成視覺誤導? | 2.5 |
| 10 | 請說明「職業懷疑心」的定義,以及它與 SIFT 的關聯。 | 2.6 |
2.8 Excel 實習課 — 資料輸入與格式設定
每週除了兩堂正課,本課程還有實習課——兩班分開,各由一位助教帶領,以 Excel 實作為主軸。上週認識了工作環境,本週要開始建立資料的品質基礎。
本週實習課對應教學計畫第 2 週實習課欄位「資料輸入與格式設定」。
實習目標
- 了解資料類型的分類:文字、數字、日期、貨幣,以及各自適用的場合
- 學會正確的資料輸入技巧,避免常見的輸入錯誤
- 掌握儲存格格式設定:數字格式、貨幣符號、小數位數、日期格式
實習內容
助教會示範資料輸入與格式設定,並帶領同學完成以下練習:
- 建立資料表:新增工作表,建立一個會計科目表,包含「日期」、「摘要」、「科目」、「金額」、「備註」五個欄位。
- 資料類型輸入:練習輸入文字(摘要)、數字(金額)、日期(交易日期)三種不同類型的資料,並觀察 Excel 如何自動辨識與對齊。
- 格式設定:將「金額」欄設定為貨幣格式(新臺幣、千分位、小數二位);將「日期」欄設定為統一的日期格式。
- 資料清理:找出並修正常見的輸入問題——數字被存成文字(儲存格左上角綠色三角)、日期格式不一致、多餘的空格。
- 檔案管理:將檔案儲存為「Week02_練習_學號姓名.xlsx」,上傳至 iClass 作業區。
後續每週實習課的 Excel 主題將逐步深入:公式與函數、排序篩選與圖表、樞紐分析表、財務函數等,為會計實務工作建立試算表操作能力。
2.9 課後任務與下週預告
課後任務:SIFT 查證實戰練習
本週我們學會了 SIFT 四步法。請你找一則本週在社群媒體或通訊軟體上看到的可疑訊息(財經、科技或生活類皆可),實際運用四個步驟查證,並記錄過程:
- S — Stop:你第一時間的情緒反應是什麼?
- I — Investigate:發布來源是誰?網域為何?過往公信力如何?
- F — Find better coverage:你找到哪些獨立來源?它們怎麼說?
- T — Trace:原始出處在哪裡?是否被去脈絡化?
最後寫下你的判斷:✅ 真實 / ❌ 虛假 / ⚠️ 視覺誤導(數據未造假但呈現方式造成誤解)/ 🤔 無法確認,並說明理由。
繳交方式與期限:於下次上課前上傳至 iClass 作業區(檔名:Week02_學號姓名)。下次上課開始的前 5 分鐘,教師將抽點 1–2 位同學分享查證過程——這項作業的重點是「查證方法的練習」,請務必寫下你的判斷依據。
下週預告
第 3 週為教師節放假。第 4 週我們將進入「AI 基礎與倫理」——從「辨識他人製作的資訊」進到「自己使用 AI 時的專業界線」,探討生成式科技的智慧財產權與專業倫理準則。
本週學到的 SIFT 四步法與橫向閱讀,會在後續每一週的資料查找與案例研究中持續使用;而「法定揭露管道」的概念,也會在後面討論成本效益分析(第 12 週)與數位時代的會計專業(第 13 週)時再次出現。